

€ 66,88 Gratis verzending

Uitgelicht
|
|
66,88 |
Naar shop
|

|
88,41 |
Naar shop
|
| VERGELIJK ALLE AANBIEDERS (2) | ||
 Beschrijving
Vergelijk aanbieders (2)
€ 66,88 Gratis verzending
€ 88,41 € 6,27 verzendkosten Totaal € 94,68
Winkels met andere maten
Beschrijving
(1)
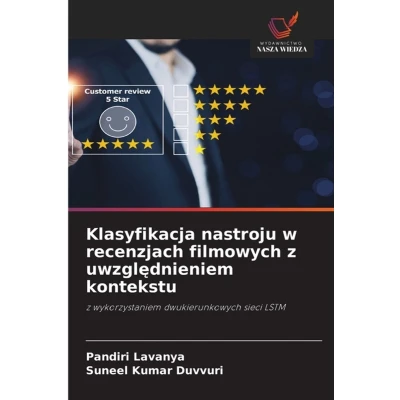
Szybki rozwój platform cyfrowych spowodowal ogromny wzrost ilości treści generowanych przez użytkowników, zwlaszcza recenzji filmowych. Ręczna analiza takich danych jest trudna i czasochlonna. Analiza sentymentu, będąca ważnym obszarem przetwarzania języka naturalnego (NLP), pomaga w automatycznej identyfikacji opinii wyrażonych w tekście. W niniejszym badaniu opracowano system oparty na uczeniu glębokim, slużący do klasyfikacji recenzji filmowych jako pozytywnych lub negatywnych. Wykorzystano zbiór danych IMDB zawierający 50 000 oznaczonych recenzji. Wstępne przetwarzanie danych obejmowalo usuwanie tagów HTML, normalizację, tokenizację, usuwanie slów zbędnych oraz stemming. Przetworzony tekst zostal przeksztalcony do postaci numerycznej przy użyciu osadzeń slów w celu uchwycenia znaczenia. Zastosowano model dwukierunkowego LSTM, który odczytuje tekst w obu kierunkach, aby lepiej zrozumiec kontekst niż modele tradycyjne. Model zostal wytrenowany przy użyciu optymalizatora Adam i straty binarnej entropii krzyżowej, z zastosowaniem wczesnego zatrzymania w celu ograniczenia nadmiernego dopasowania. Wyniki wykazaly dokladnośc na poziomie okolo 88,5%, co potwierdza skutecznośc modelu. Podejście to można zastosowac w systemach rekomendacji, analizie mediów spolecznościowych oraz ocenie opinii.
 Prijshistorie
* Prijshistorie bevat geen data van Amazon.
Prijzen voor het laatst bijgewerkt op:
 Gerelateerde resultaten
 Productspecificaties


