
Riconoscimento della fiducia espressa in linguaggio naturale nelle recensioni online di Amazon: Estrazione affermazioni eterotiche relative al ... un corpus dei clienti Amazon
Uitgelicht
|
47,99 |
Naar shop
|

|
70,61 |
Naar shop
|

|
70,61 |
Naar shop
|
| VERGELIJK ALLE AANBIEDERS (3) | ||
 Beschrijving
Bol
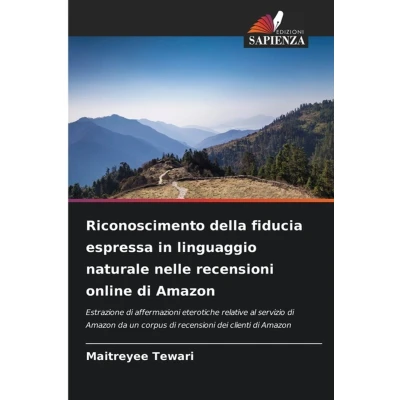
L'obiettivo del progetto è rendere Internet un mondo credibile. Questo progetto rappresenta un primo passo verso l'automazione del processo di estrazione della fiducia. Il progetto prevede l'analisi, l'estrazione e il perfezionamento dei dati etici disponibili su Internet. Il progetto è stato avviato con la raccolta di dati da diverse fonti, quali biblioteche online o siti web. Successivamente, i dati sono stati puliti (rimuovendo le parole vuote e i segni di punteggiatura), annotati e si è proceduto alla creazione di un classificatore. L'intero progetto ha subito diverse iterazioni per arrivare a una soluzione affidabile. Il progetto ha utilizzato diverse tecniche di elaborazione del linguaggio naturale, quali l'argument mining e l'analisi del sentiment, nonché algoritmi di apprendimento automatico come i modelli Naive Bayes e Maxent, discussi in dettaglio nella tesi. I software utilizzati sono stati Python e i relativi toolkit per l'elaborazione del linguaggio, quali il Natural Language Toolkit (NLTK) e TextBlob. Il contributo di questo progetto è stato il seguente: è stata raccolta e annotata una ricca quantità di dati e sono stati realizzati due classificatori in grado di estrarre le affermazioni etotiche e classificarle.


 Beschrijving
(1)
L'obiettivo del progetto è rendere Internet un mondo credibile. Questo progetto rappresenta un primo passo verso l'automazione del processo di estrazione della fiducia. Il progetto prevede l'analisi, l'estrazione e il perfezionamento dei dati etici disponibili su Internet. Il progetto è stato avviato con la raccolta di dati da diverse fonti, quali biblioteche online o siti web. Successivamente, i dati sono stati puliti (rimuovendo le parole vuote e i segni di punteggiatura), annotati e si è proceduto alla creazione di un classificatore. L'intero progetto ha subito diverse iterazioni per arrivare a una soluzione affidabile. Il progetto ha utilizzato diverse tecniche di elaborazione del linguaggio naturale, quali l'argument mining e l'analisi del sentiment, nonché algoritmi di apprendimento automatico come i modelli Naive Bayes e Maxent, discussi in dettaglio nella tesi. I software utilizzati sono stati Python e i relativi toolkit per l'elaborazione del linguaggio, quali il Natural Language Toolkit (NLTK) e TextBlob. Il contributo di questo progetto è stato il seguente: è stata raccolta e annotata una ricca quantità di dati e sono stati realizzati due classificatori in grado di estrarre le affermazioni etotiche e classificarle.
 Productspecificaties
 Prijshistorie
* Prijshistorie bevat geen data van Amazon, Amazon Marketplace.
Prijzen voor het laatst bijgewerkt op:
 Gerelateerde resultaten


